ทีมหน้างานเข้าถึงระบบได้สะดวก
ใช้งาน HIS ผ่านเว็บเบราว์เซอร์บนคอมพิวเตอร์หรือแท็บเล็ตที่รองรับ ช่วยให้วางจุดใช้งานสำหรับห้องตรวจ หอผู้ป่วย และหน่วยงานสนับสนุนได้ตาม workflow โดยกำหนดสิทธิ์และเครือข่ายที่อนุญาตให้เข้าถึงร่วมกัน
CK DOCTOR · HOSPITAL INFORMATION SYSTEM
CK Doctor มีแนวทางติดตั้งแบบ Local Intranet, Cloud และ Hybrid การเลือกรูปแบบควรพิจารณาความพร้อมของเครือข่าย ทีมดูแล ข้อมูลที่ต้องเชื่อม และแผนความต่อเนื่องของโรงพยาบาล พร้อมตกลงขอบเขตความรับผิดชอบของแต่ละฝ่าย
ขอสาธิตและประเมินราคา HIS
การติดตั้งภายในองค์กรให้โรงพยาบาลจัดการโครงสร้างพื้นฐานในขอบเขตของตน แต่ต้องวางคนดูแล อุปกรณ์ ไฟฟ้า เครือข่าย การสำรอง และการบำรุงรักษาร่วมกัน
การใช้ Cloud ต้องประเมินการเชื่อมต่อจากหน้างาน การควบคุมบัญชี ตำแหน่งจัดเก็บข้อมูล การสำรอง และเงื่อนไขบริการ ความพร้อมของผู้ให้บริการไม่ได้แทนแผนความต่อเนื่องของโรงพยาบาลทั้งหมด
Hybrid อาจแบ่งระบบและข้อมูลไว้หลายตำแหน่ง ต้องอธิบายแหล่งข้อมูลหลัก การส่งข้อมูล และการตอบสนองเมื่อการเชื่อมต่อขาดหาย การมีสองตำแหน่งไม่ได้หมายความว่าสลับใช้งานหรือทำงานออฟไลน์ได้โดยอัตโนมัติ
Web-based คือการเข้าใช้งานผ่านเว็บเบราว์เซอร์ ส่วน Microservices คือการแบ่งระบบเบื้องหลังเป็นบริการย่อยที่เชื่อมต่อกัน ทั้งสองแนวคิดช่วยให้วางรูปแบบการใช้งาน การขยาย และการดูแลได้เหมาะกับโรงพยาบาล
ใช้งาน HIS ผ่านเว็บเบราว์เซอร์บนคอมพิวเตอร์หรือแท็บเล็ตที่รองรับ ช่วยให้วางจุดใช้งานสำหรับห้องตรวจ หอผู้ป่วย และหน่วยงานสนับสนุนได้ตาม workflow โดยกำหนดสิทธิ์และเครือข่ายที่อนุญาตให้เข้าถึงร่วมกัน
ประเมิน On-premise, Cloud หรือ Hybrid จากนโยบายข้อมูล อินเทอร์เน็ต ทีมดูแล และงบประมาณ การใช้งานผ่านเว็บสามารถออกแบบให้เข้าถึงผ่านเครือข่ายภายในโรงพยาบาลได้ โดยขอบเขตการเข้าถึงขึ้นอยู่กับรูปแบบติดตั้ง
การแยกบริการช่วยให้วางแผนเพิ่มทรัพยากรตามโหลดของแต่ละส่วน เช่น บริการรายงานที่มีงานประมวลผลมาก โดยต้องประเมินฐานข้อมูล เครือข่าย และบริการที่พึ่งพาร่วมกัน เพื่อให้การลงทุนตรงกับคอขวดจริง
แบ่งขอบเขตการปรับปรุงและการอัปเดตตามบริการ ช่วยให้ทดสอบและวางแผนส่งมอบการเปลี่ยนแปลงในขอบเขตที่เล็กลง พร้อมตรวจสอบงานที่เชื่อมต่อและเตรียมแผนย้อนกลับก่อนใช้งานจริง
Kubernetes ช่วยให้บริการฟื้นตัว ขยาย และอัปเดตอย่างไร
ทีม CK Doctor ช่วยประเมินสิทธิ์ผู้ใช้ การเชื่อมต่อ การเฝ้าระวัง และแผนสำรองร่วมกับรูปแบบติดตั้ง เพื่อให้ความปลอดภัย ความเสถียร และค่าใช้จ่ายสอดคล้องกับบริบทของโรงพยาบาล
MICROSERVICES · DOCKER · KUBERNETES
สำหรับโรงพยาบาล ความน่าสนใจคือการลดงานแก้ปัญหาซ้ำ ๆ ของทีม IT และเตรียมระบบให้รับมือกับช่วงงานหนาแน่น Kubernetes ช่วยควบคุมให้บริการทำงานตามจำนวนและเงื่อนไขที่วางไว้ พร้อมจัดการเมื่อบางส่วนขัดข้อง
Microservices แบ่งแอปเป็นบริการย่อย Docker ช่วยแพ็กแอปและสิ่งที่ต้องใช้เป็น Container ส่วน Kubernetes ช่วยจัดวางและดูแล Container เหล่านั้นบนกลุ่มเซิร์ฟเวอร์
Self-healing: เมื่อ Container หยุดทำงาน Kubernetes สามารถเริ่มใหม่หรือสร้างตัวทดแทน และส่งงานไปยังตัวที่พร้อมให้บริการตามการตรวจสุขภาพที่ตั้งไว้ ช่วยลดงานที่ต้องรอคนเข้ามารีสตาร์ต โดยยังต้องแก้สาเหตุของปัญหาควบคู่กัน
Autoscaling: ตั้งให้เพิ่มหรือลดจำนวนตัวให้บริการตามภาระงานได้ เช่น ช่วงเช้าที่มีการเรียกดูข้อมูลมากขึ้น ช่วยใช้ทรัพยากรตามความจำเป็น เมื่อมีระบบวัดโหลด ทรัพยากรเพียงพอ และแอปรองรับการทำงานหลายตัวร่วมกัน
Rolling Update: ค่อย ๆ นำเวอร์ชันใหม่มารับงานแทนเวอร์ชันเดิม ช่วยลดช่วงหยุดบริการเมื่อมีจำนวนตัวให้บริการและการตรวจความพร้อมที่เหมาะสม ทีม IT สามารถสั่งย้อนเวอร์ชันแอปได้ โดยต้องตรวจความเข้ากันได้ของฐานข้อมูลและระบบที่เชื่อมต่อด้วย
Resource Management: ระบุทรัพยากรที่แต่ละบริการต้องการและกำหนดเพดานการใช้ ช่วยวางบริการบนเครื่องที่เหมาะสมและควบคุมการแย่งทรัพยากร ต้องติดตามการใช้งานจริงเพื่อปรับให้สมดุลกับประสิทธิภาพและงบประมาณ
ตัวอย่างการออกแบบ: บริการค้นข้อมูลที่รองรับการขยาย อาจเพิ่มจาก 2 เป็น 4 ตัวเมื่อโหลดสูง และลดกลับเมื่อโหลดเบาลง หากตัวหนึ่งหยุดทำงาน ตัวที่พร้อมยังรับงานต่อระหว่างสร้างตัวทดแทน ทั้งนี้ต้องประเมินคอขวดที่ฐานข้อมูลและเครือข่ายร่วมด้วย
ผลลัพธ์ขึ้นอยู่กับการวางระบบทั้งแอป ฐานข้อมูล พื้นที่เก็บข้อมูล และเครือข่าย การตั้งหลายตัวบนเครื่องเดียวก็ยังเสี่ยงเมื่อเครื่องนั้นขัดข้อง ทีม CK Doctor ช่วยประเมินรูปแบบที่เหมาะกับงบประมาณ พร้อมแผนสำรอง กู้คืน และทดสอบเป้าหมาย RTO / RPO ร่วมกัน
ดูแนวทางความต่อเนื่องและ RTO / RPO
อ่านหลักการจากเอกสาร Kubernetes: ภาพรวมและการดูแลบริการ · Autoscaling · Rolling Update
เริ่มจากประเมินว่างานใดหยุดได้แค่ไหน และข้อมูลช่วงใดที่ยอมรับให้สูญหายได้ เช่น งานตรวจรักษา สั่งยา บันทึกการให้ยา และการเงิน แล้วจึงออกแบบโครงสร้างพื้นฐานและแผนกู้คืนให้ตรงกับเป้าหมาย
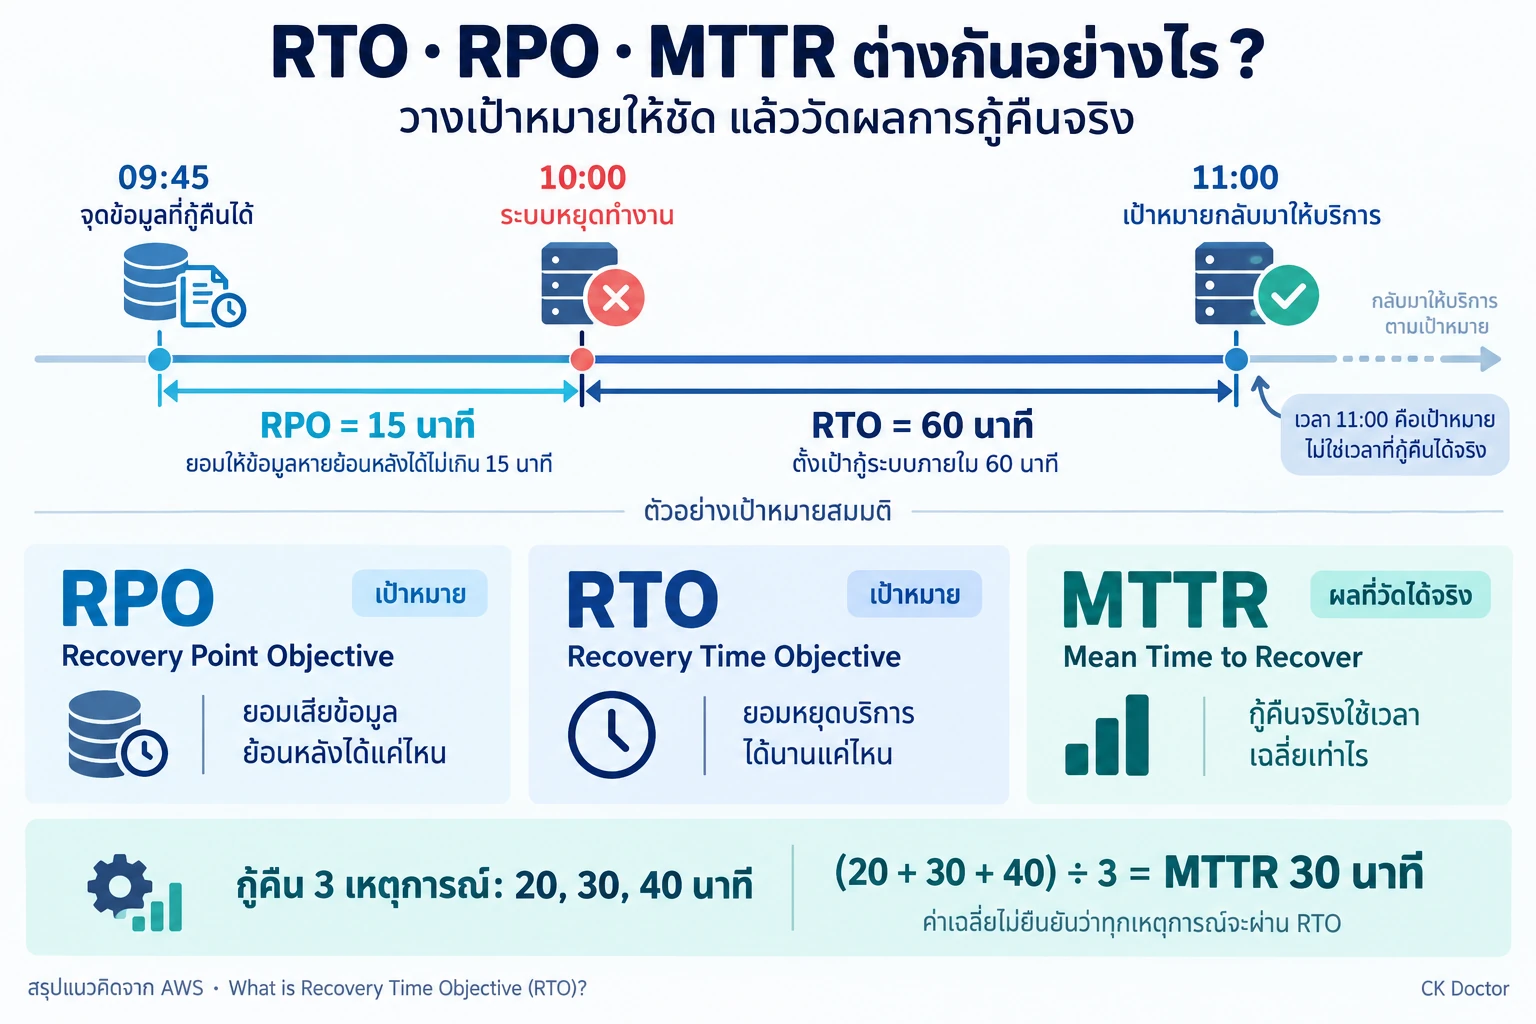
Recovery Time Objective คือเป้าหมายระยะเวลาสูงสุดที่ยอมรับได้ ตั้งแต่บริการหยุดชะงักจนกู้กลับมาให้ใช้งานได้ ต้องพิจารณาทั้งระบบ HIS ฐานข้อมูล ระบบเชื่อมต่อ และการกลับมาทำงานของผู้ใช้
Recovery Point Objective คือช่วงเวลาสูงสุดของข้อมูลที่ยอมรับให้สูญหายได้ระหว่างจุดกู้คืนล่าสุดกับเวลาที่เกิดเหตุ ใช้กำหนดแนวทางสำรองและจำลองข้อมูล รวมถึงวิธีตรวจสอบความครบถ้วนหลังการกู้คืน
Mean Time to Recover คือเวลาเฉลี่ยที่ใช้กู้ระบบจากหลายเหตุการณ์ เช่น 20, 30 และ 40 นาที เท่ากับ MTTR 30 นาที ใช้เทียบกับ RTO เพื่อปรับปรุงการกู้คืน โดยค่าเฉลี่ยไม่ได้ยืนยันว่าทุกเหตุการณ์ผ่านเป้าหมาย
CK Doctor มีโซลูชันช่วยลดช่วงหยุดให้บริการ โดยประเมินทางเลือก HA การสำรองและกู้คืนข้อมูล และแผน DR ให้เหมาะกับความสำคัญของงานและงบประมาณของโรงพยาบาล พร้อมอธิบายขอบเขตและค่าใช้จ่ายของแต่ละทางเลือกเพื่อให้ตัดสินใจได้อย่างเหมาะสม
การเข้าใกล้เป้าหมาย Near-Zero Downtime ขึ้นอยู่กับสถาปัตยกรรม โครงสร้างพื้นฐาน การวางระบบ และสถานการณ์ที่ต้องรองรับ จึงต้องตกลงขอบเขต RTO / RPO และทดสอบการสลับระบบหรือกู้คืนตามกรณีที่กำหนดร่วมกัน
ประเมินโซลูชันและค่าใช้จ่ายให้เหมาะกับโรงพยาบาล
ค่า RTO / RPO เป็นเป้าหมายที่ต้องตกลงตามความสำคัญของงาน รูปแบบติดตั้ง และงบประมาณ แล้วทดสอบการกู้คืนพร้อมบันทึกผลจริง การมี HA หรือข้อมูลสำรองเพียงอย่างเดียวไม่ได้ยืนยันว่าจะทำได้ตามเป้าหมายทุกกรณี
นำคำถามเหล่านี้ไปคุยกับทีม IT ผู้ใช้งาน และผู้รับผิดชอบโครงการ
ต้องพิจารณางานที่สำคัญ โครงสร้างพื้นฐาน งบดูแล และความสามารถของทีม พร้อมเปรียบเทียบต้นทุนตลอดช่วงใช้งานในขอบเขตเดียวกัน
ควรทดสอบการกู้คืนและการกลับมาทำงานของกระบวนการจริง รวมทั้งข้อมูลตั้งต้น สิทธิ์ ระบบเชื่อมต่อ และผู้รับผิดชอบเมื่อเกิดเหตุ
แจ้งหน่วยงาน workflow และระบบที่ต้องเชื่อมต่อ เพื่อให้ทีมงานเตรียมสาธิตและประเมินขอบเขตที่เหมาะสม